浅谈vue3渲染过程和编译原理
Vue3的渲染过程包括创建应用实例、挂载应用、响应式系统触发渲染、虚拟DOM diff算法和应用更新。编译原理涉及词法分析、语法分析、转换和生成四个步骤,通过有限状态自动机解析模板为Token,生成抽象语法树(AST),再转换为JavaScript AST,最后生成渲染函数代码。
阴晴圆缺都休说,且喜人间好时节。
vue3渲染过程和编译原理
渲染过程
Vue3的渲染过程主要可以分为以下几个步骤:
- 创建应用实例
- 使用
createApp方法创建Vue应用实例,传入组件选项对象,包括模板(template)、组合式API的入口setup函数等。 - 在
setup函数中,使用ref或reactive创建响应式数据,并返回给模板使用。
- 使用
- 挂载应用实例
- 调用应用实例的
mount方法,将模板渲染到指定的DOM元素内。 - 在挂载过程中,Vue会创建虚拟DOM,它是一个轻量级的JavaScript对象,用来描述DOM结构。
- 调用应用实例的
- 响应式系统触发渲染
- 当响应式数据发生变化时,Vue的响应式系统会检测到这一变化。
- 响应式系统会触发重新渲染,生成新的虚拟DOM树。
- 虚拟DOM diff算法
- Vue使用高效的diff算法比较新旧虚拟DOM树的差异。
- 只更新实际DOM中需要变化的部分,从而最小化真实DOM的操作,提升页面渲染速度。
- 应用更新
- 根据diff算法的结果,Vue更新实际DOM,以反映最新的组件状态。
也就是说,在创建好应用 app 后执行 mount 函数,通过 createVNode 将我们的入口组件 App.vue 转换成 VNode 树,最后使用 patch() 函数将 VNode 树转换为真实 Dom 渲染到页面上。
编译原理
Vue3的编译过程是将模板转换为可执行的渲染函数的过程,主要包括以下几个步骤:
- 词法分析(parse)
- 使用有限状态机对模板字符串进行分割,生成一系列的词法单元(Tokens)。
- 这些Tokens是模板中的基本组成单元,如标签、文本、属性等。
- 也就是通过调用
parse函数,生成抽象语法树(AST)
- 语法分析
- 在通过
parse解析得到的抽象语法树后,对其进行语法分析,得到模板 AST - 此外,在构建AST的过程中,Vue会进行一些优化操作,如静态提升(Static Hoisting)。静态提升是将模板中的静态内容(不会随数据变化而变化的内容)提升到渲染函数之外,以避免不必要的重新渲染。
- 在通过
- 转换(transform)
- 在语法分析的基础上,需要通过
transform函数将模板 AST转换为JavaScript AST,因为 Vue模板编译器的最终目标是生成渲染函数,而渲染函数本质上是 JavaScript 代码
- 在语法分析的基础上,需要通过
- 生成(generate)
- 有了
JavaScript AST后,再通过generate函数生成渲染函数
- 有了
- 生成渲染函数(render)
- 最后,Vue将AST转换为可执行的JavaScript代码,即渲染函数(Render Function)。
- 渲染函数是一个纯函数,它接收状态作为输入,并返回描述UI的虚拟DOM节点。
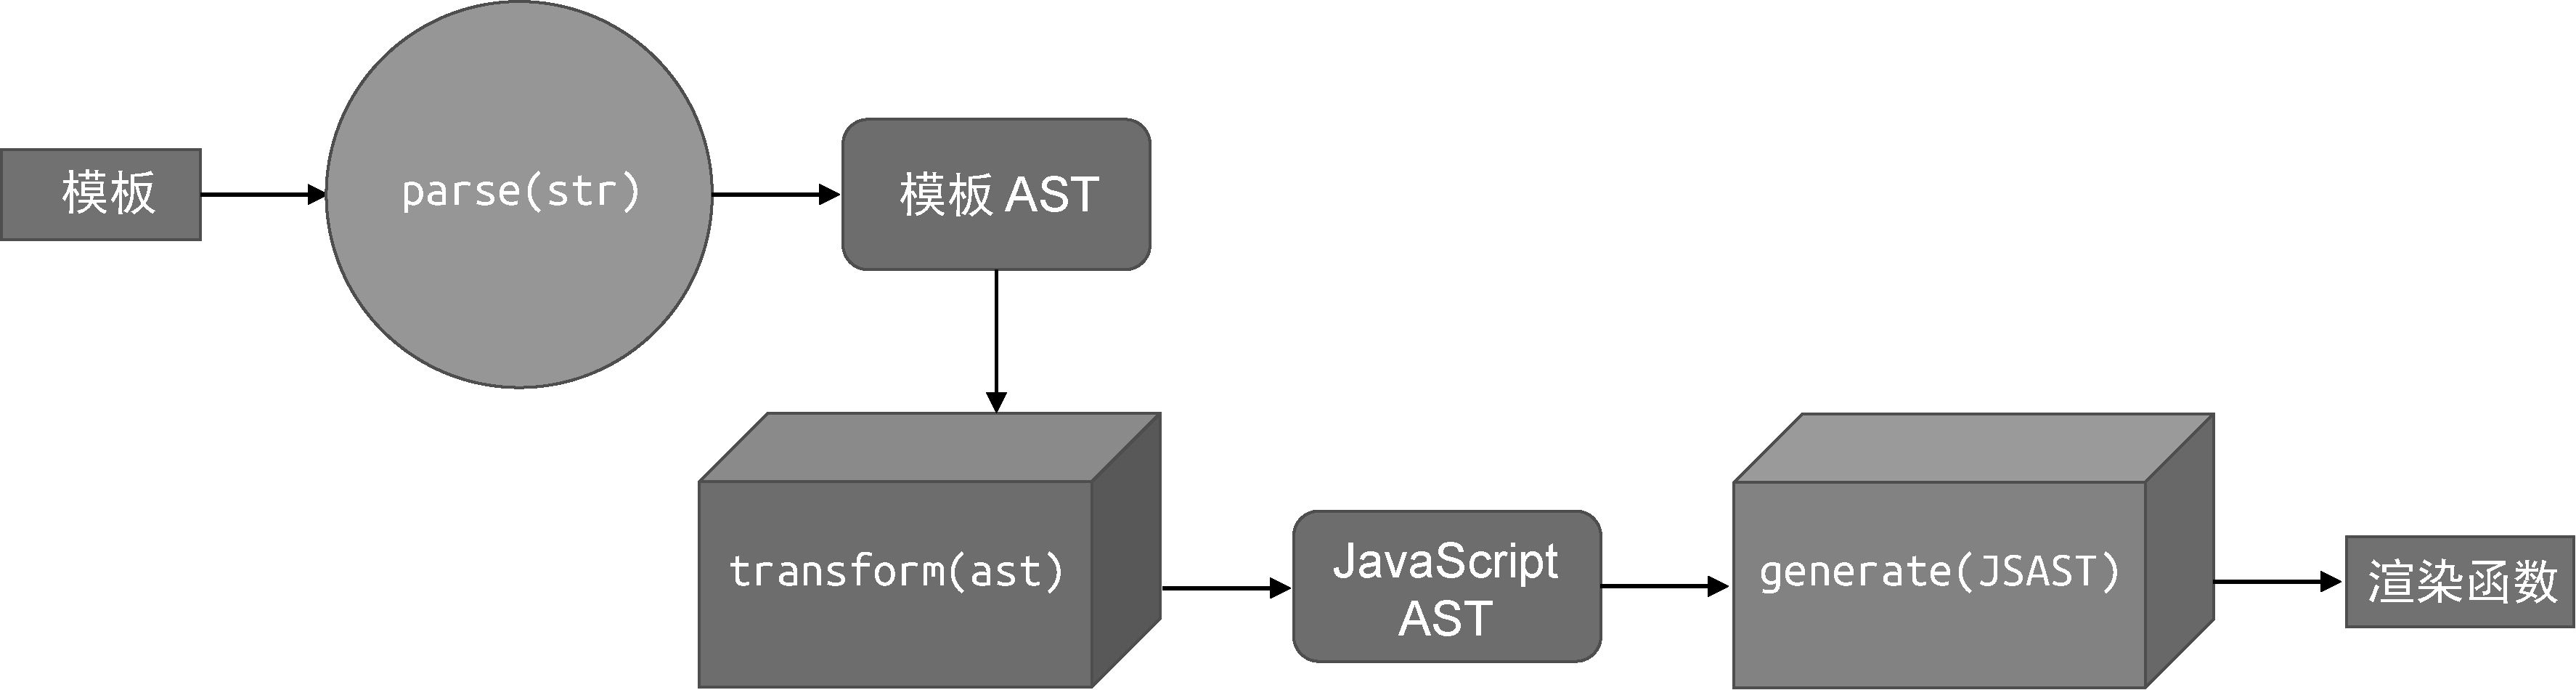
Vue模板编译器的基本结构主要由三个部分组成:
-
用来将模板字符串解析为模板 AST 的解析器(parser)
-
用来将模板 AST 转换为 JavaScript AST 的转换器
(transformer)
-
用来根据 JavaScript AST 生成渲染函数代码的生成器
(generator)
parser的实现原理
解析器(parser)的入参是字符串模板,逐个读取字符串模板中的字符,通过有限状态自动机,解析为一个个Token,进而可以用它们构建抽象语法树AST
列如:
html
<p>Vue</p>解析器通过有限状态自动机会把这段字符串模板切割为三个 Token
- 开始标签:
<p>。 - 文本节点:
Vue。 - 结束标签:
</p>。
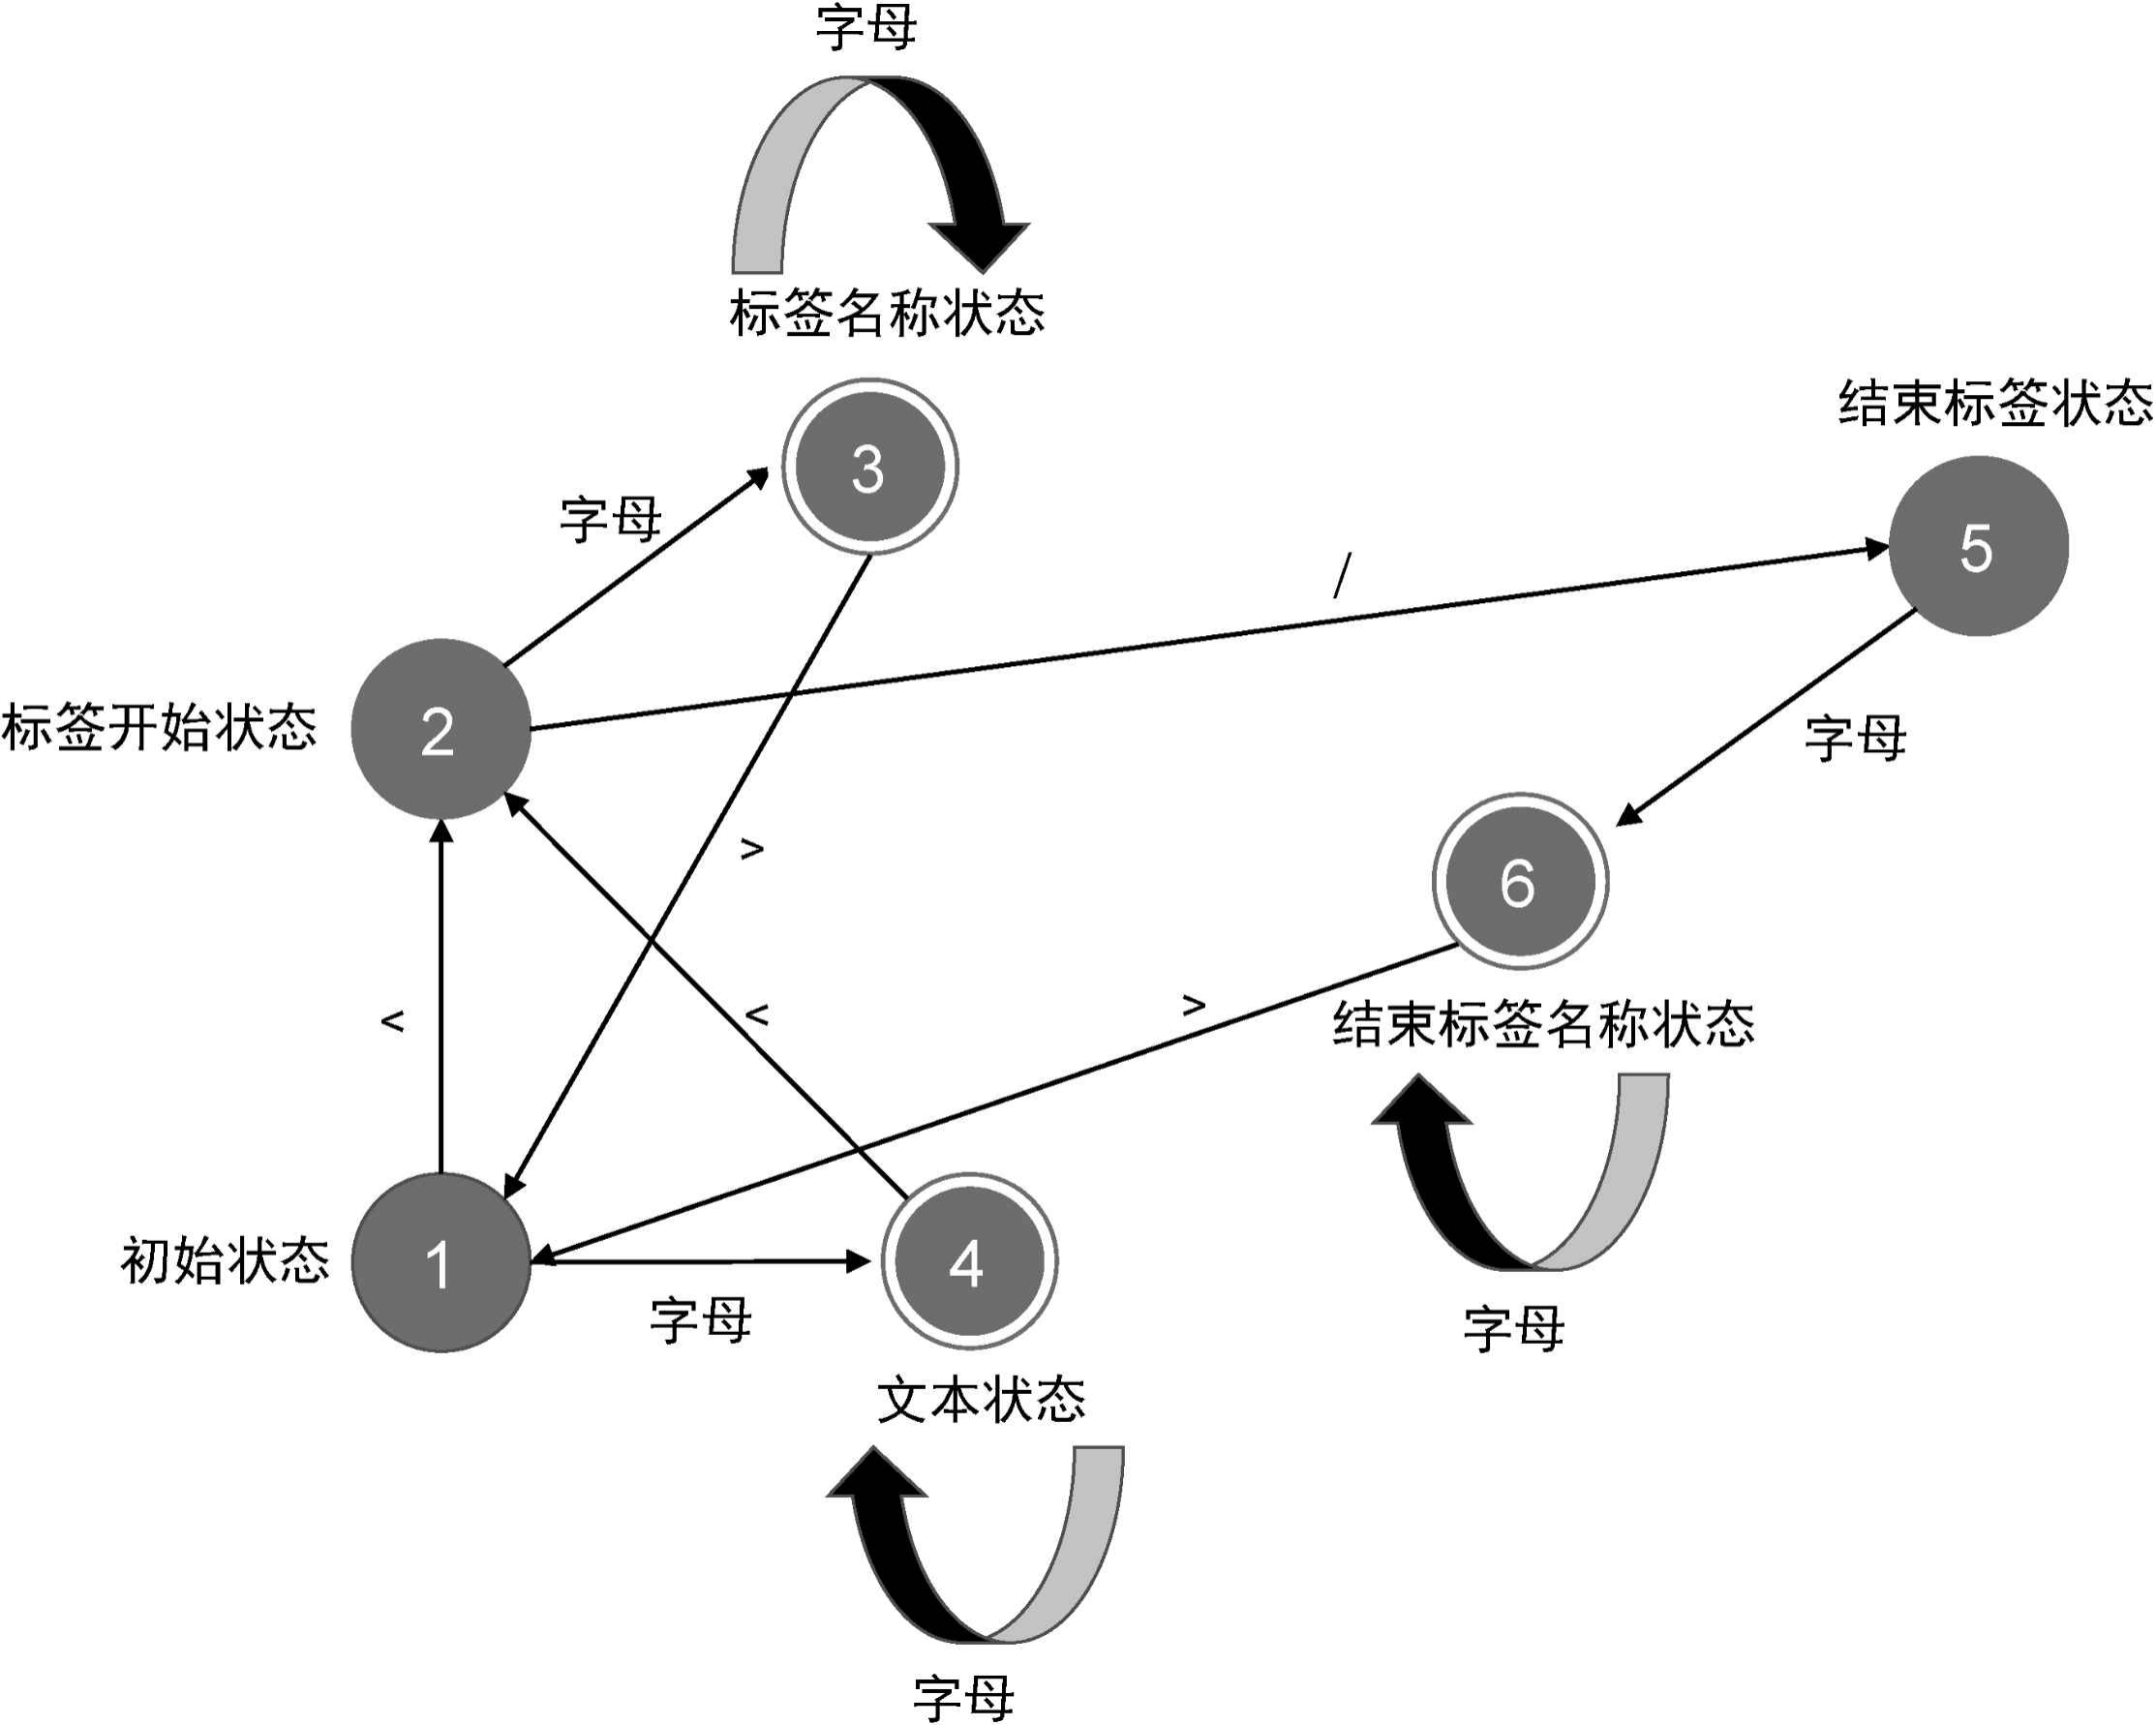
有限状态自动机:大概意思就是说,有限个状态,随着字符的输入,解析器会自动地在不同状态间迁移。如下图:
-
状态机始于“初始状态 1”。在“初始状态 1”下,读取模板的第一个字符
<,状态机会进入下一个状态,即“标签开始状态 2”。 -
在“标签开始状态 2”下,读取下一个字符
p。由于字符p是字母,所以状态机会进入“标签名称状态 3”。 -
在“标签名称状态 3”下,读取下一个字符
>,此时状态机会从“标签名称状态 3”迁移回“初始状态 1”,并记录在“标签名称状态”下产生的标签名称p。 -
在“初始状态 1”下,读取下一个字符
V,此时状态机会进入“文本状态 4”。 -
在“文本状态 4”下,继续读取后续字符,直到遇到字符
<时,状态机会再次进入“标签开始状态 2”,并记录在“文本状态 4”下产生的文本内容,即字符串Vue。 -
在“标签开始状态 2”下,读取下一个字符
/,状态机会进入“结束标签状态 5”。 -
在“结束标签状态 5”下,读取下一个字符
p,状态机会进入“结束标签名称状态 6”。 -
在“结束标签名称状态 6”下,读取最后一个字符
>,它是结束标签的闭合字符,于是状态机迁移回“初始状态 1”,并记录在“结束标签名称状态 6”下生成的结束标签名称。
经过这样一系列的状态迁移过程之后,我们最终就能够得到相应的 Token 了。
一个简单的解析token如下代码:
typescript
// 定义状态机的状态
const State = {
    initial: 1, // 初始状态
    tagOpen: 2, // 标签开始状态
    tagName: 3, // 标签名称状态
    text: 4, // 文本状态
    tagEnd: 5, // 结束标签状态
    tagEndName: 6 // 结束标签名称状态
}

// 一个辅助函数,用于判断是否是字母
function isAlpha(char) {
    return char >= 'a' && char <= 'z' || char >= 'A' && char <= 'Z';
}

// 接收模板字符串作为参数,并将模板切割为 Token 返回
function tokenize(str) {
    // 状态机的当前状态:初始状态
    let currentState = State.initial;
    // 用于缓存字符
    const chars = [];
    // 生成的 Token 会存储到 tokens 数组中,并作为函数的返回值返回
    const tokens = [];
    // 使用 while 循环开启自动机,只要模板字符串没有被消费尽,自动机就会一直运行
    while(str) {
        // 查看第一个字符,注意,这里只是查看,没有消费该字符
        const char = str[0];
        // switch 语句匹配当前状态
        switch (currentState) {
            // 状态机当前处于初始状态
            case State.initial:
                // 遇到字符 <
                if (char === '<') {
                    // 1. 状态机切换到标签开始状态
                    currentState = State.tagOpen;
                    // 2. 消费字符 <
                    str = str.slice(1);
                } else if (isAlpha(char)) {
                    // 1. 遇到字母,切换到文本状态
                    currentState = State.text;
                    // 2. 将当前字母缓存到 chars 数组
                    chars.push(char);
                    // 3. 消费当前字符
                    str = str.slice(1);
                }
                break;
            // 状态机当前处于标签开始状态
            case State.tagOpen:
                if (isAlpha(char)) {
                    // 1. 遇到字母,切换到标签名称状态
                    currentState = State.tagName;
                    // 2. 将当前字符缓存到 chars 数组
                    chars.push(char);
                    // 3. 消费当前字符
                    str = str.slice(1);
                } else if (char === '/') {
                    // 1. 遇到字符 /,切换到结束标签状态
                    currentState = State.tagEnd;
                    // 2. 消费字符 /
                    str = str.slice(1);
                }
                break;
            // 状态机当前处于标签名称状态
            case State.tagName:
                if (isAlpha(char)) {
                    // 1. 遇到字母,由于当前处于标签名称状态,所以不需要切换状态,
                    // 但需要将当前字符缓存到 chars 数组
                    chars.push(char);
                    // 2. 消费当前字符
                    str = str.slice(1);
                } else if (char === '>') {
                    // 1. 遇到字符 >,切换到初始状态
                    currentState = State.initial;
                    // 2. 同时创建一个标签 Token,并添加到 tokens 数组中
                    // 注意,此时 chars 数组中缓存的字符就是标签名称
                    tokens.push({
                        type: 'tag',
                        name: chars.join('')
                    });
                    // 3. chars 数组的内容已经被消费,清空它
                    chars.length = 0;
                    // 4. 同时消费当前字符 >
                    str = str.slice(1);
                }
                break;
            // 状态机当前处于文本状态
            case State.text:
                if (isAlpha(char)) {
                    // 1. 遇到字母,保持状态不变,但应该将当前字符缓存到 chars 数组
                    chars.push(char);
                    // 2. 消费当前字符
                    str = str.slice(1);
                } else if (char === '<') {
                    // 1. 遇到字符 <,切换到标签开始状态
                    currentState = State.tagOpen;
                    // 2. 从 文本状态 --> 标签开始状态,此时应该创建文本 Token,
                    // 并添加到 tokens 数组
                    // 注意,此时 chars 数组中的字符就是文本内容
                    tokens.push({
                        type: 'text',
                        content: chars.join('')
                    });
                    // 3. chars 数组的内容已经被消费,清空它
                    chars.length = 0;
                    // 4. 消费当前字符
                    str = str.slice(1);
                }
                break;
            // 状态机当前处于标签结束状态
            case State.tagEnd:
                if (isAlpha(char)) {
                    // 1. 遇到字母,切换到结束标签名称状态
                    currentState = State.tagEndName;
                    // 2. 将当前字符缓存到 chars 数组
                    chars.push(char);
                    // 3. 消费当前字符
                    str = str.slice(1);
                }
                break;
            // 状态机当前处于结束标签名称状态
            case State.tagEndName:
                if (isAlpha(char)) {
                    // 1. 遇到字母,不需要切换状态,但需要将当前字符缓存到 chars 数组
                    chars.push(char);
                    // 2. 消费当前字符
                    str = str.slice(1);
                } else if (char === '>') {
                    // 1. 遇到字符 >,切换到初始状态
                    currentState = State.initial;
                    // 2. 从 结束标签名称状态 --> 初始状态,应该保存结束标签名称 Token
                    // 注意,此时 chars 数组中缓存的内容就是标签名称
                    tokens.push({
                        type: 'tagEnd',
                        name: chars.join('')
                    });
                    // 3. chars 数组的内容已经被消费,清空它
                    chars.length = 0;
                    // 4. 消费当前字符
                    str = str.slice(1);
                }
                break;
        }
    }

    // 最后,返回 tokens
    return tokens;
}

console.log(tokenize('<p>Vue</p>'))
// 最后得到结果如下
/**
[
  { type: 'tag', name: 'p' },
  { type: 'text', content: 'Vue' },
  { type: 'tagEnd', name: 'p' }
]
*/其实,有时候并不需要所有的token,因为在HTML模板标签中,结束的标签token是可以省略的,如<p/>,此时就没有结束标签了。此外,上面例子也是可以通过正则表达式来实现,正则表达式的本质就是有限状态自动机。当你编写正则表达式的时候,其实就是在编写有限状态自动机。
transform转换
访问 AST 的每一个节点,对特定节点进行修改、替换、删除等操作,如
- 处理
v-if指令:将v-if指令转换为条件表达式。 - 处理文本节点:将文本节点转换为字符串字面量。
总而言之, transform 阶段通过深度优先遍历 AST 并应用一系列转换规则,将模板 AST 转换为适合生成 JavaScript 代码的形式
generate生成
根据 JavaScript AST 生成渲染函数代码。代码生成本质上是字符串拼接的艺术。我们需要访问 JavaScript AST 中的节点,为每一种类型的节点生成相符的 JavaScript 代码。
编译的主要流程代码如下:
typescript
function compile(template) {
  // 模板 AST
  const ast = parse(template);
  // 将模板 AST 转换为 JavaScript AST
  transform(ast);
  // 代码生成
  const code = generate(ast.jsNode);
  return code;
}
如:
vue
<script setup>
</script>

<template>
  <h1></h1>
</template>
生成渲染函数如下:
typescript
// 生成代码如下
function render(_ctx, _cache) {
  return (_openBlock(), _createElementBlock("h1"))
}